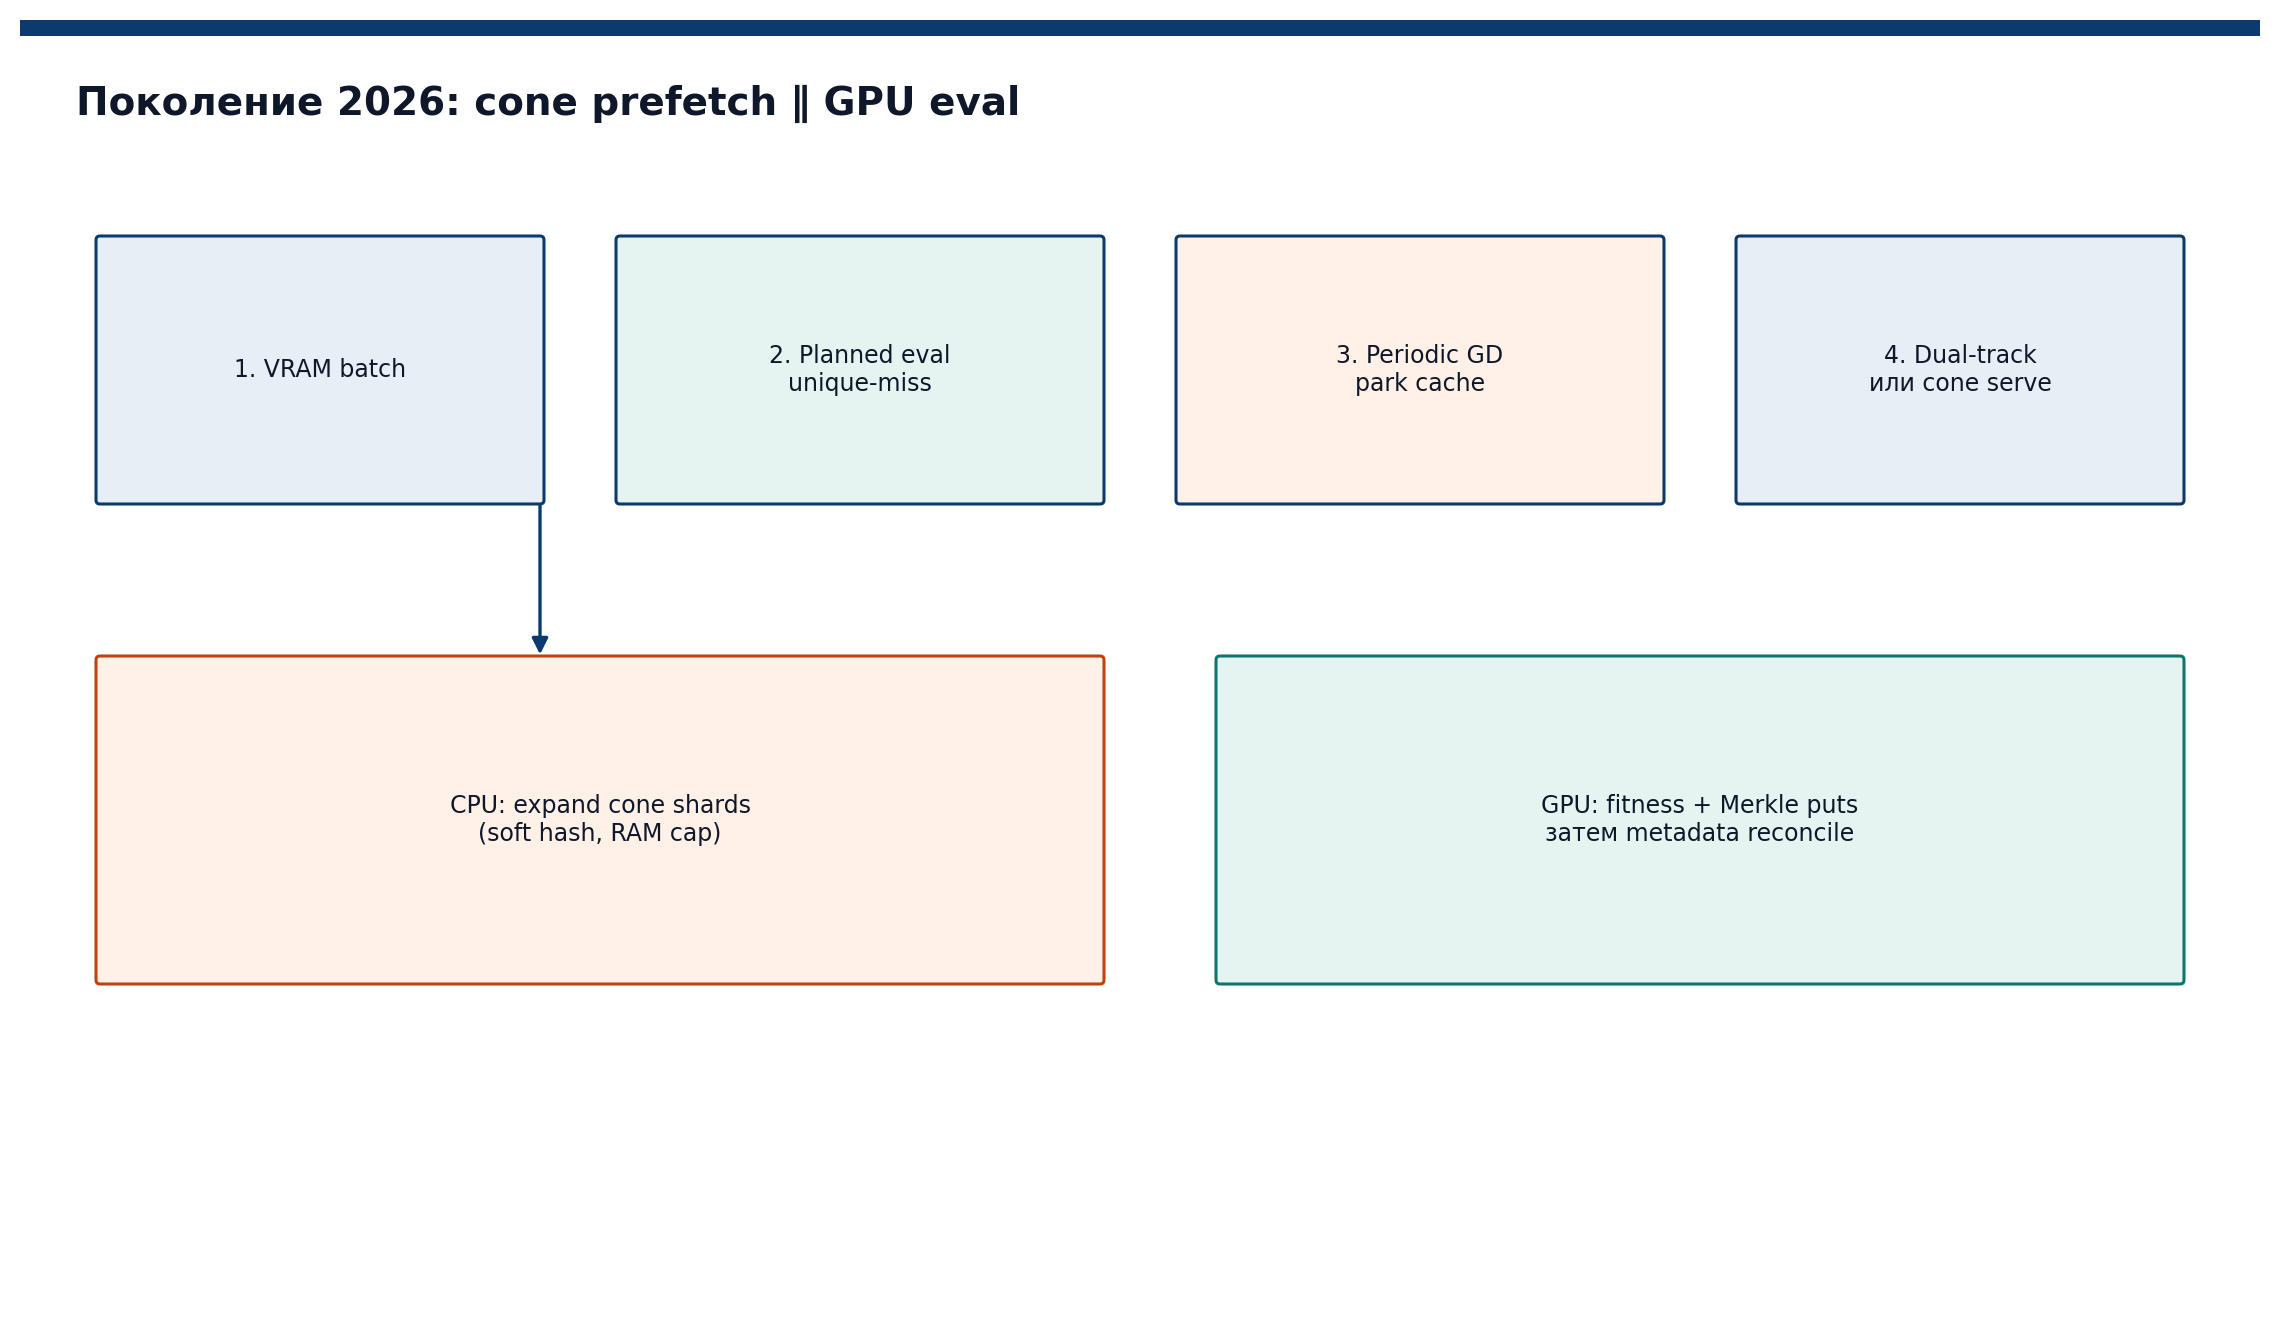
Цикл эволюции (2026)
cnn_neat.evolution_loop.run_evolution оркестрирует кэши, GD, cone и Studio. Псевдокод отражает текущий код, не только классический NEAT.
Вход: ExperimentConfig cfg
  device ← configure_gpu_for_training(cfg)   # или CPU + periodic_gd_device=cuda
  set_seed(cfg.seed)
  val / screen loaders, GPUValCache
  vram_ctrl ← VRAMBatchController(cfg)
  pop_vram ← PopulationVRAMManager(cfg)
  neat ← create_evolver(cfg)
  cone ← BreedingConeService(...) если breeding_cone_enabled
  hash_cache ← ForwardActivationCache(...) если fitness_forward_hash_cache_enabled
  write_run_meta; write_studio_status

  пока gen < num_generations (или не stagnation):
    eval_cfg ← replace(cfg, eval_batch_size=vram_ctrl.current)

    # --- Fitness ---
    если planned hash-cache:
      plan_population_misses + execute_planned_population
    иначе если tiered:
      evaluate_population_fitness_tiered(+ screen_cache / hash_cache)
    иначе:
      evaluate_population_fitness
    neat.set_fitness_scores(...)
    если dynamic_population_enabled:
      pop ← occupancy (max(VRAM, cache) **этого** гена, цель ~60–70%, рост ≤×1.2)
      если cache уже держал ≥ cache_min и occupancy жмёт pop ниже cache_min:
        выключить hash-cache, pop остаётся и растёт occupancy до naive_max;
        seed 8 < 10 сам по себе кэш не выключает;
        CUDA OOM сначала режет pop и повторяет с кешем; drop — только на min;
        genome-stagnation patience не пересчитывается (бюджет геномов)
    stagn += 1 поколение или N full-eval геномов (`stagnation_unit`)

    # --- Periodic GD ---
    если should_run_periodic_gd:
      park forward-cache и spill train cache
      run_periodic_gd_on_population (device может быть cuda при CPU-eval)
      selective invalidate Merkle maps; restore never-GD
      cone.wipe + warmup

    # --- Elite refinement (опционально) ---
    если should_run_elite_refinement:
      select_elites_with_gradient_refinement

    # --- Размножение ---
    если dual_track после первого GD:
      neat.evolve_dual_track(...)
    иначе если cone:
      serve ← cone.serve(); neat.evolve_with_cone(serve)
    иначе:
      neat.evolve(elites)
    reconcile hash-cache metadata-only (без второго forward)

    build_generation_summary; archive shard; dashboard; studio_status
    vram_ctrl.maybe_shrink; optional empty_cuda_cache
    on_generation_end(record)
    если stagnation_patience: break

  save_final_run_report
Callback on_generation_end(record) — live dashboard study и Studio. Record содержит best_* метрики, timing_*, флаги periodic_gd_applied, elite_refinement_applied, размеры кэша.